跳转到主要内容
分数落在控制台的评测页上,和其他每次运行在同一张矩阵里,跨运行、跨方法、跨底座模型都可比。
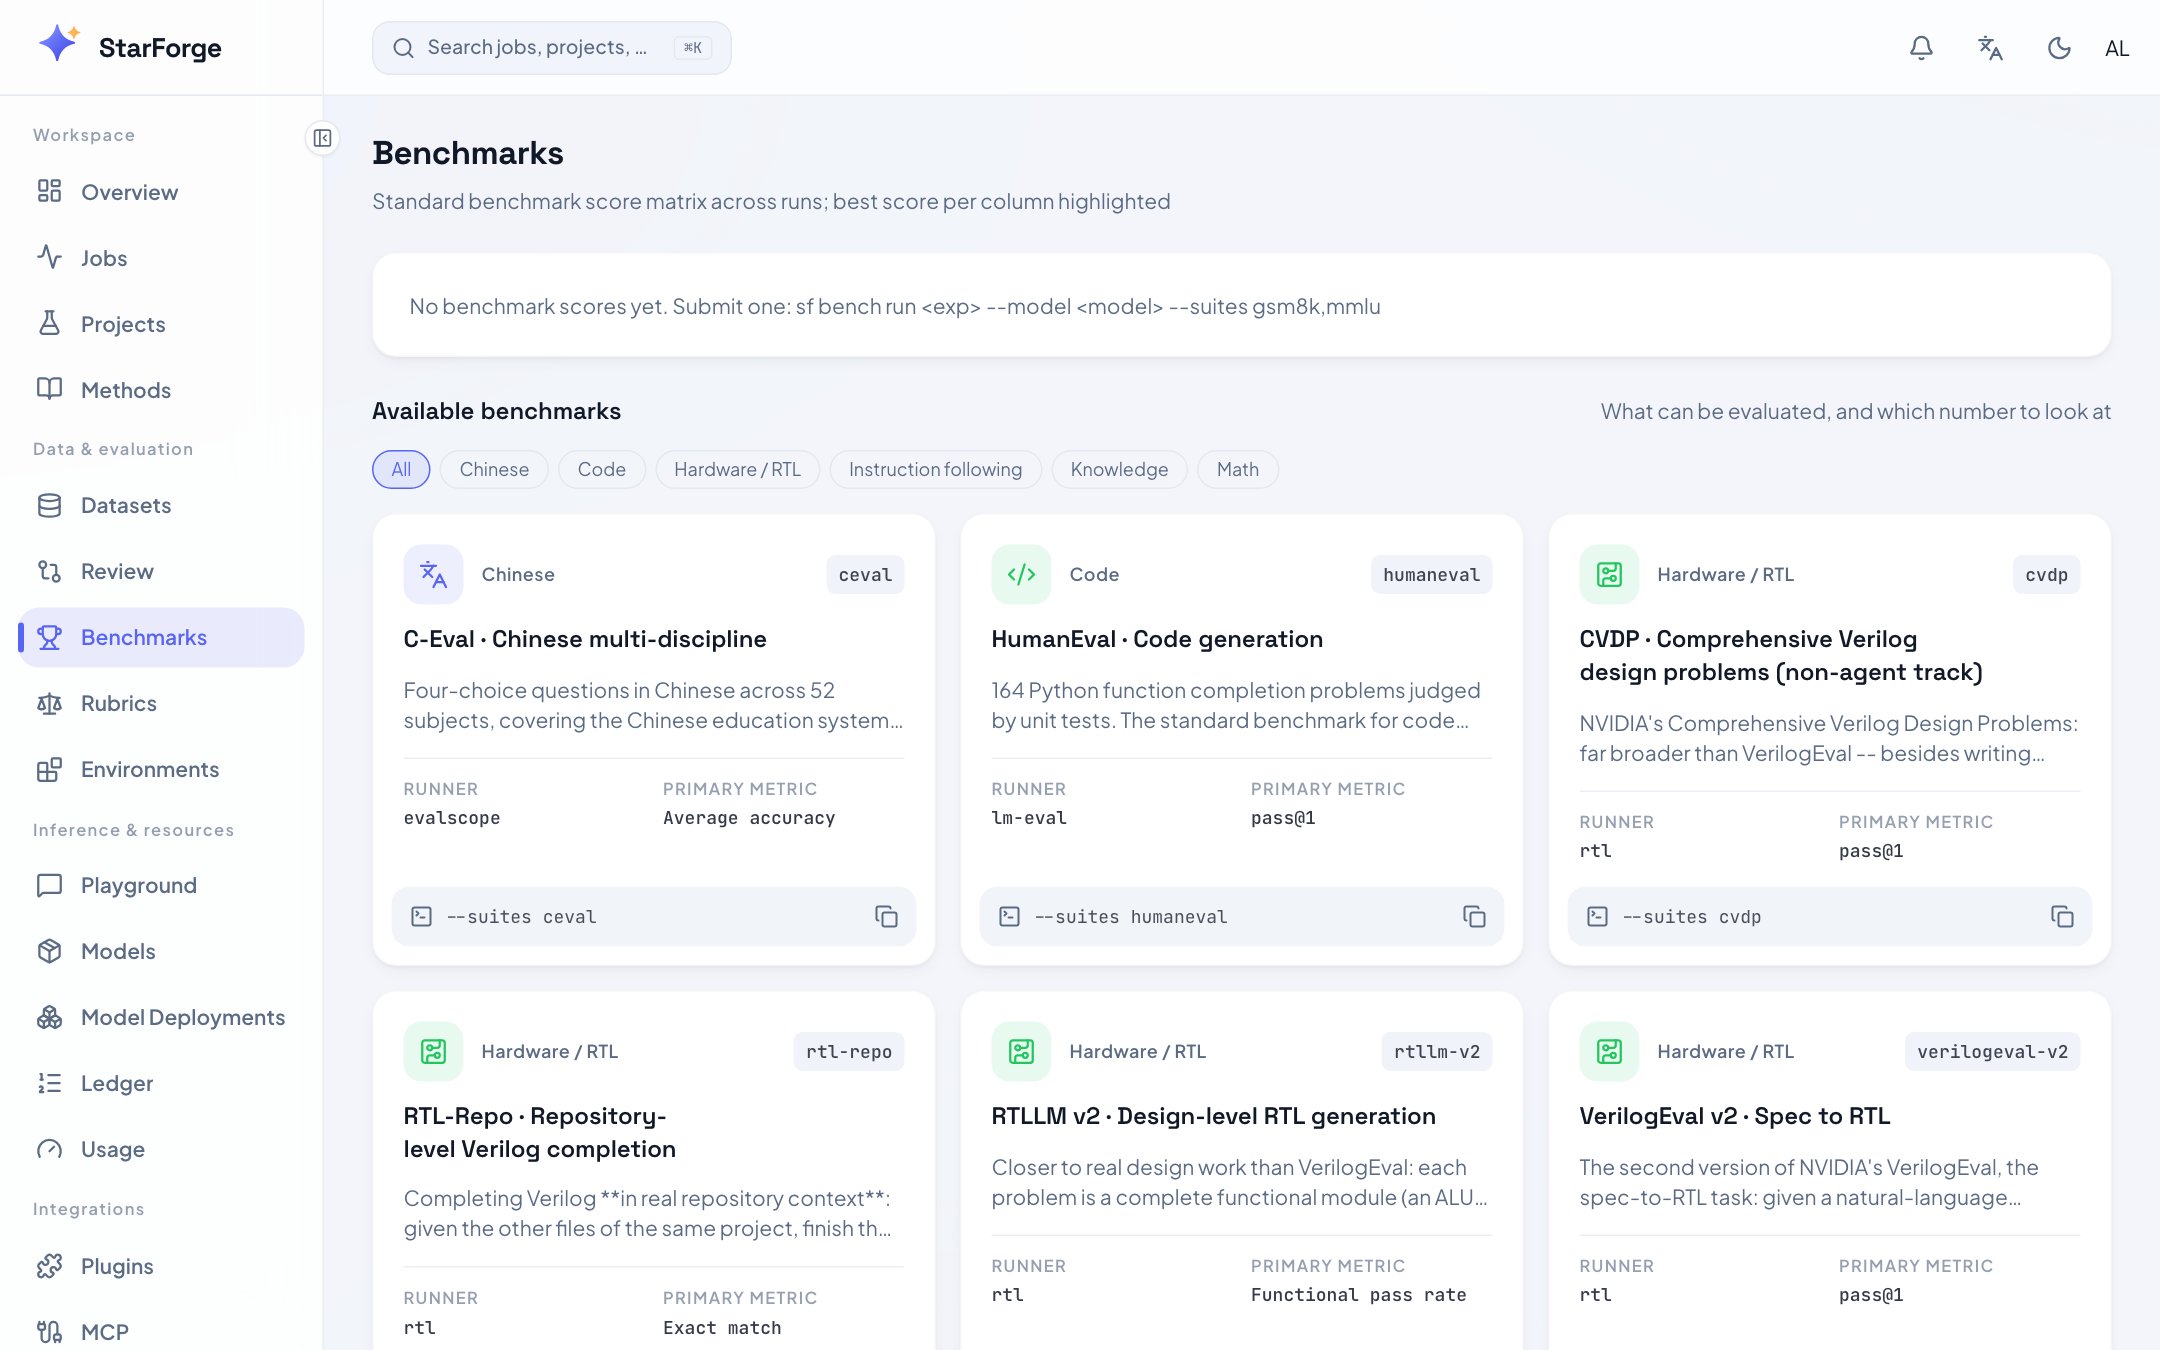
TunePlane 评测页

评测矩阵:运行按行,评测集按列,列内最高分高亮。

能给什么打分

给一次运行打分要求它已经导出过。提交时加 --then export 能免掉你去记这件事。

挑评测集

内置的有 gsm8k、math、humaneval、mmlu、ceval、ifeval,加上 RTL 那几个。任何以 benchmark pack 发布的也会出现在这里。 跨类别多跑几个。后训练会稳定地改善一个轴、同时悄悄损坏另一个,而这只有在你测了不止你在优化的那个 轴时才看得见。

值得知道的参数

带 --limit 的分数和完整跑出来的分数不可比,而且下游没有任何东西会把它标成被截断过。用它确认 管线通了,然后不带它再跑。
两个 runner 产出同一份评分契约,所以同一个评测集不管谁跑都可比。

让每次运行都自动打分

手动跑一次没问题。让它在每次运行上都发生,才是阻止一次回退进到生产的方式。实验配置里的评测门禁 更进一步:低于阈值的运行会被标成未过门禁。见你方法模板里的 eval: 段。

上报一个跑不进来的 harness 的分数

一个有许可证的工具,或一台物理测试台:
create 返回一个 run id,submit 把分数文件报到它上面。--train-run 是让评测门禁和模型注册表把 这些分数当作权威的那个参数;没有它,分数会被记下但不权威。 它们进同一张矩阵,标注为外部产生。

确认成功

然后打开评测页。你那次运行出现一行,且每个请求的列里都有分数,就成功了。某一列是空的表示那个评测集 失败了,作业日志里会说明是哪个。 分数的写入是幂等的:重新上报同一个运行和同一个评测集会更新那一行,而不是加第二行。

怎么读这张矩阵

每个指标都带一个声明过的方向,所以看板不用猜哪边更好。一个评测集上报多个指标时,它们之间的差值 往往是有用的那部分:GSM8K 的 strict 和 flexible 匹配分开来,说明模型会算但没有按要求的格式写答案。

下一步

写一个 benchmark pack声明你自己的评测集 · 评分标准给没有规则能判定对错的任务打分 · 对比多次运行