

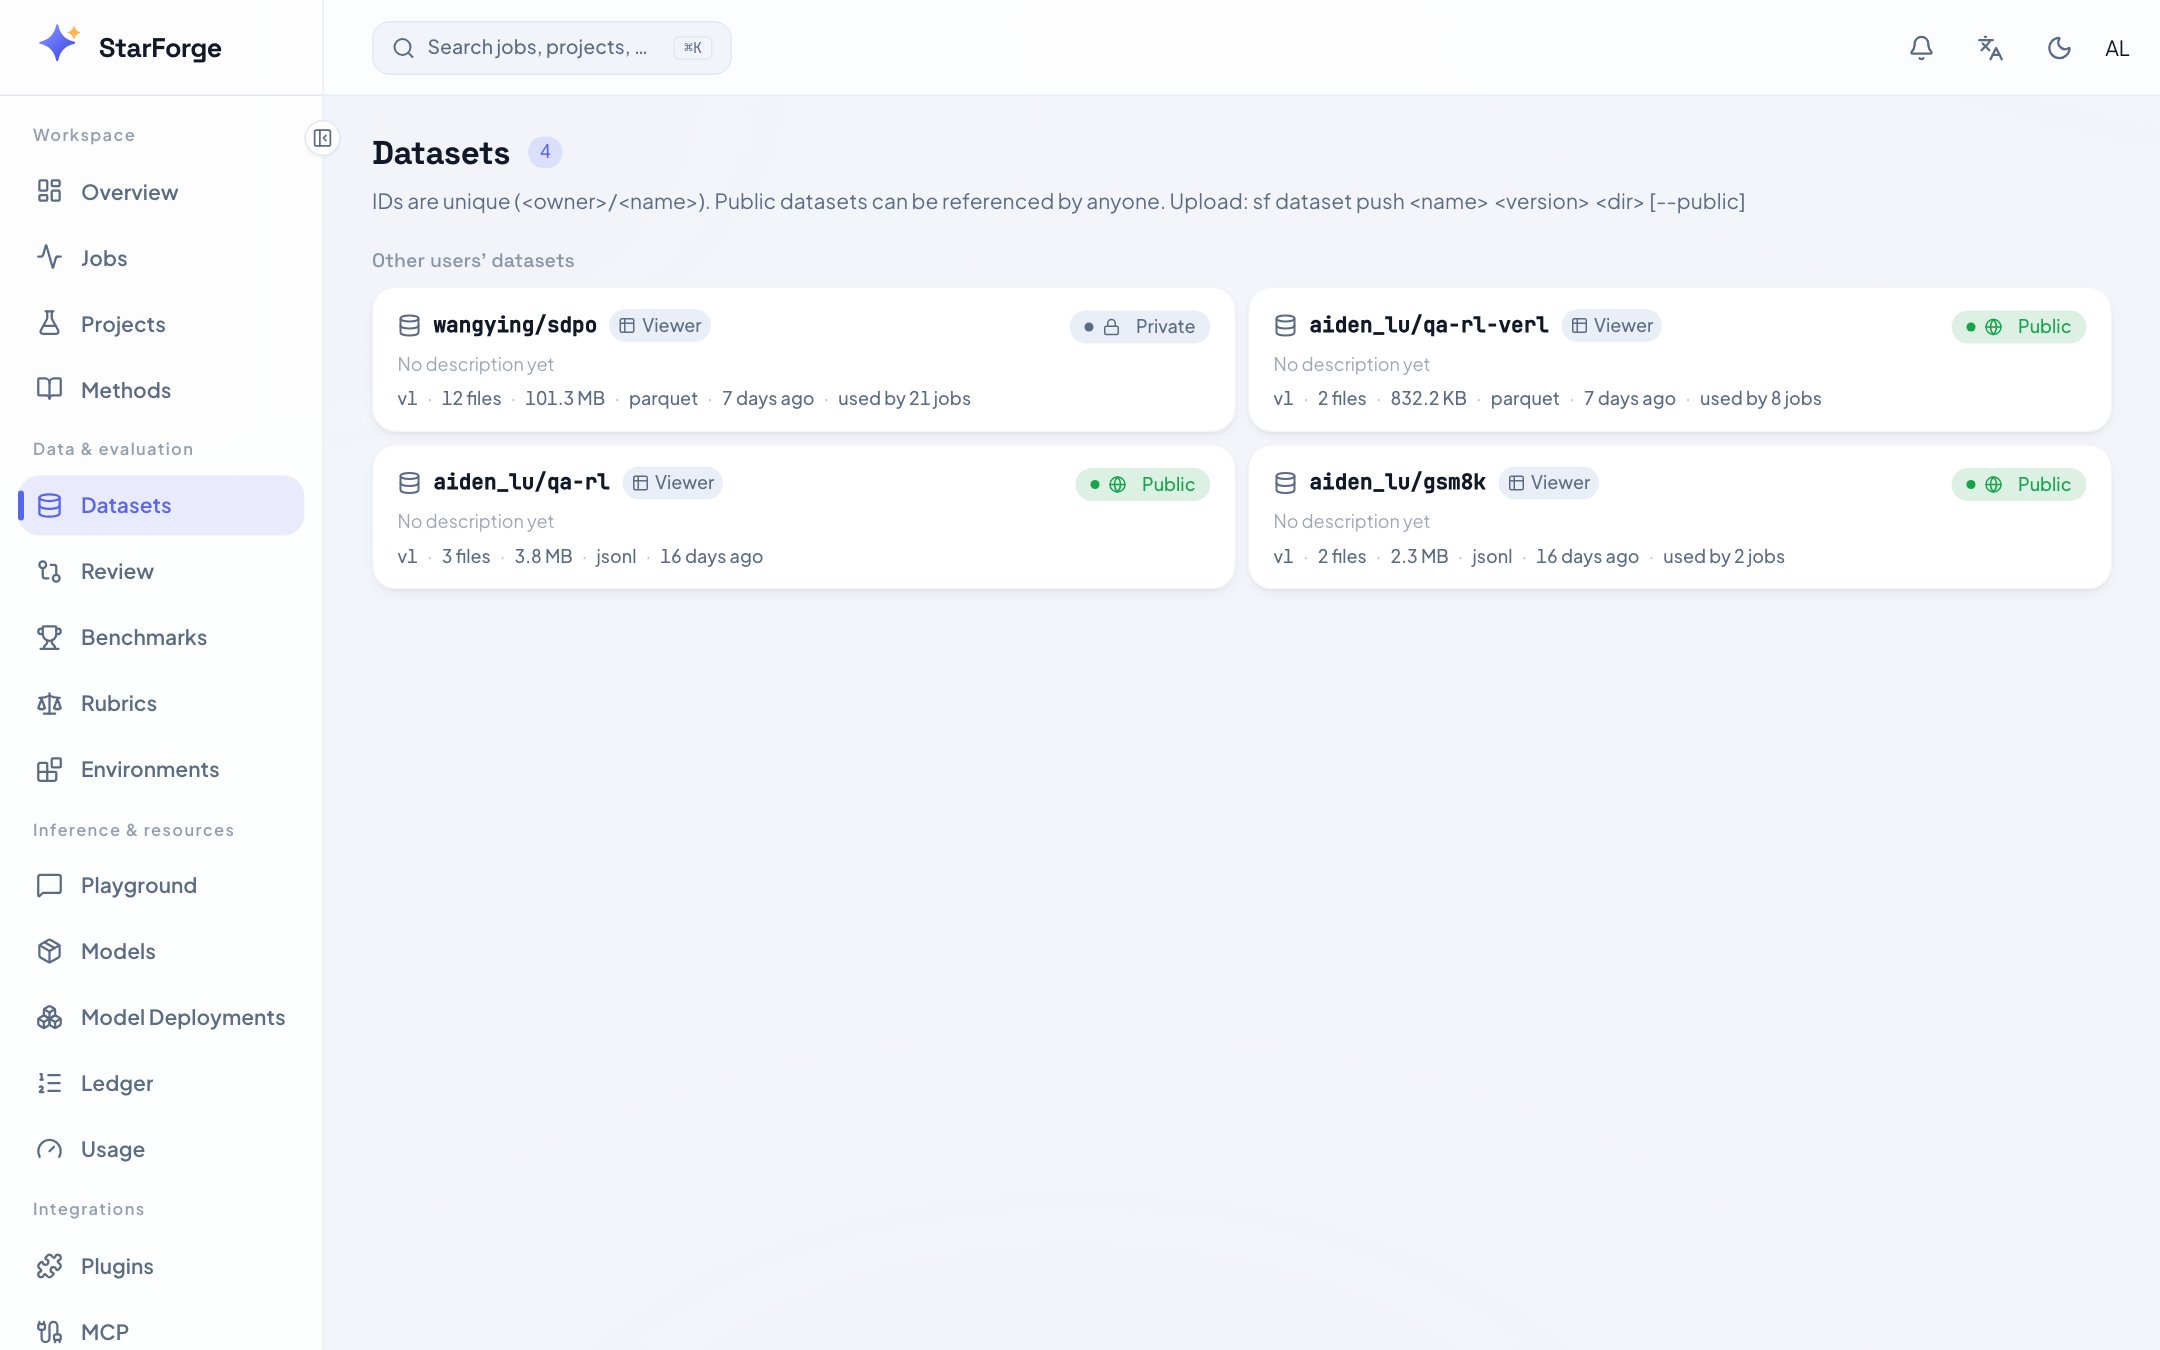
数据集版本,含文件清单与质量指标。
/data 分为三个标签页:数据集固定输入版本,数据卷读取目录的当前内容,治理规则管理检测定义。
数据集和数据卷都可以供训练、评估和预处理作业使用。
旧的
/datasets 和 /volumes 链接都落到这里。
两种详情页都会展示可复制的 作业引用 和 使用指南。数据集指南跟随所选版本和文件,
数据卷指南跟随当前目录。代码示例按需展开,日常浏览时保持简洁。
你会看到什么
治理规则
打开 数据 → 治理规则,输入项目标识(例如@alice/support),选择训练或评测用途,
然后点击 打开规则。此标签页需要数据治理功能授权和项目管理权限。
项目设为公开,不代表词库和测试输入也公开。
- 使用 创建词库草稿 填写类别标识、具体字段路径,以及每行一个的词条。 正例填写一个词条,反例填写不包含词条的合成文本。生成文档 会开始一个新版本, 保存前请检查文档。多个类别、正则、限定范围的例外和更多样例可在文档编辑器中维护。 预期匹配范围使用 UTF-8 字节偏移。
- 填写修改理由并 保存新版本。已保存版本不可变,后续修改会创建另一个版本。 运行样例测试 会在有资源限制的 CPU 子进程中执行真实 Rust 匹配器。 结果必须完全符合预期,每个类别均须有正例和反例,才能发布。
- 另一位管理员打开已保存版本,检查定义、测试结果及与当前发布版本的比较, 填写复核理由后 发布规则。如果其他复核人先发布,须重新载入并再次复核。 原作者不能批准自己创建的版本。
- 恢复历史发布时,打开对应的已保存版本;如果运行环境发生变化,先重新测试, 再点击 回滚到此版本。回滚保留中间所有发布历史,同样要求独立复核。
发布规则版本不会启用严格数据策略、扫描数据集、改变现有扫描计划或批准训练输入。
合成样例通过仅代表回归检查通过,不代表全量扫描完成,也不是检测精确率或召回率评估。
下方数据集扫描徽标仍描述其抽样覆盖范围。
敏感数据扫描范围
扫描徽标描述的是文本抽样,不涵盖图片、OCR、音频或视频,也不能证明整个版本已通过 全量检查。API 将这类证据标记为coverage: sampled,未读到内容时为 unknown,
并始终标明 satisfies_full_coverage: false。这些字段不会将现有部署级报告策略变成严格治理。
发现数量优先于与其矛盾的“干净”标签,缺失的检查范围会明确展示。在权限允许时,规则命中
数量仍可查看;受保护的数据集继续隐藏摘录。需要处理数据时,请通过 Processing Run 创建
新版本;扫描报告不会改写原始数据。
质量报告
在推送时算一次,覆盖全量数据——只有非常大的数据集才采样。 它统计的是机器能统计的东西,不假装能判断内容。受保护的数据集
一个数据集可以被治理成「可以用于训练,但读不到内容」。这样的数据集在控制台上只显示 身份、版本、schema、血缘和授权状态——没有预览、没有样本记录、没有下载。 这是在服务端强制的,不是把按钮藏起来。日志、验证样本和产物受同一套策略约束, 所以它们不会变成另一条导出通道。从控制台上传
数据集列表页的上传数据集用来新建一个数据集和它的第一个版本;数据集详情页的上传新版本 是给已有数据集加一个版本。两者问的是tp dataset push 一样的三个问题——哪个数据集、哪个版本、
哪些文件——文件也一样是用预签名 URL 直传对象存储。index.json 是「这个版本已完整」的标记,
也因此让版本不可变,所以它只在全部文件都落盘之后才写:中途失败留下的是一个仍然空着的版本号,
而不是一个自称已完成的版本。
文件里如果有 README.md,会一并作为数据集说明发布,和 CLI 推送的行为一致。
质量报告和污染指纹不在浏览器里算——一个页面不会为了切 n-gram 去读几个 GB。版本出现之后,
worker 会在扫描它的同一趟里从对象存储把它们算出来,写在版本旁边,位置和 CLI 推送时写的一样。
超过单版本的读取预算时,报告会把自己标成抽样,而不是拿半个文件算出来的重复率当全量。
控制台上传拒绝超过 512 MB 的单个文件:浏览器要算校验和就得把整个文件读进内存,而这个校验和
正是作业侧用来验证下载完整性的东西。
tp dataset push 是流式的,没有这个限制——它也是在推送
时就把两份报告按全量算出来,而不是事后按预算算。你可以做什么
- 在配置里或用
--train-dataset引用某个版本。 - 在这一页,或用
tp dataset push推送新版本。 - 推送前用
tp dataset check和tp dataset quality先检查质量。
Volumes 标签页
一个 Volume 是作业通过只读挂载读取的命名目录。它没有版本:文件原地 增删,引用指向这个 volume 本身而不是它的某个快照。
那里从来没有的东西:批量下载、任何顺手的便利接口,以及所有者没打开时任何设置下的预览。列出结构
和读取内容不是一回事,而这个切分是有意的 —— 一个作业挂上一个 volume 之后已经能读它的每个字,所以
把文件名藏起来什么都保护不了。
一个 volume 的文件永远没有版本,所以要从它产出可复现的东西,跑一次发布数据集版本的
Processing Run。