

/playground)用于短时试用模型。服务带 TTL,到期自动回收;需要稳定端点、Token、自愈和 Revision 的场景请使用模型部署。
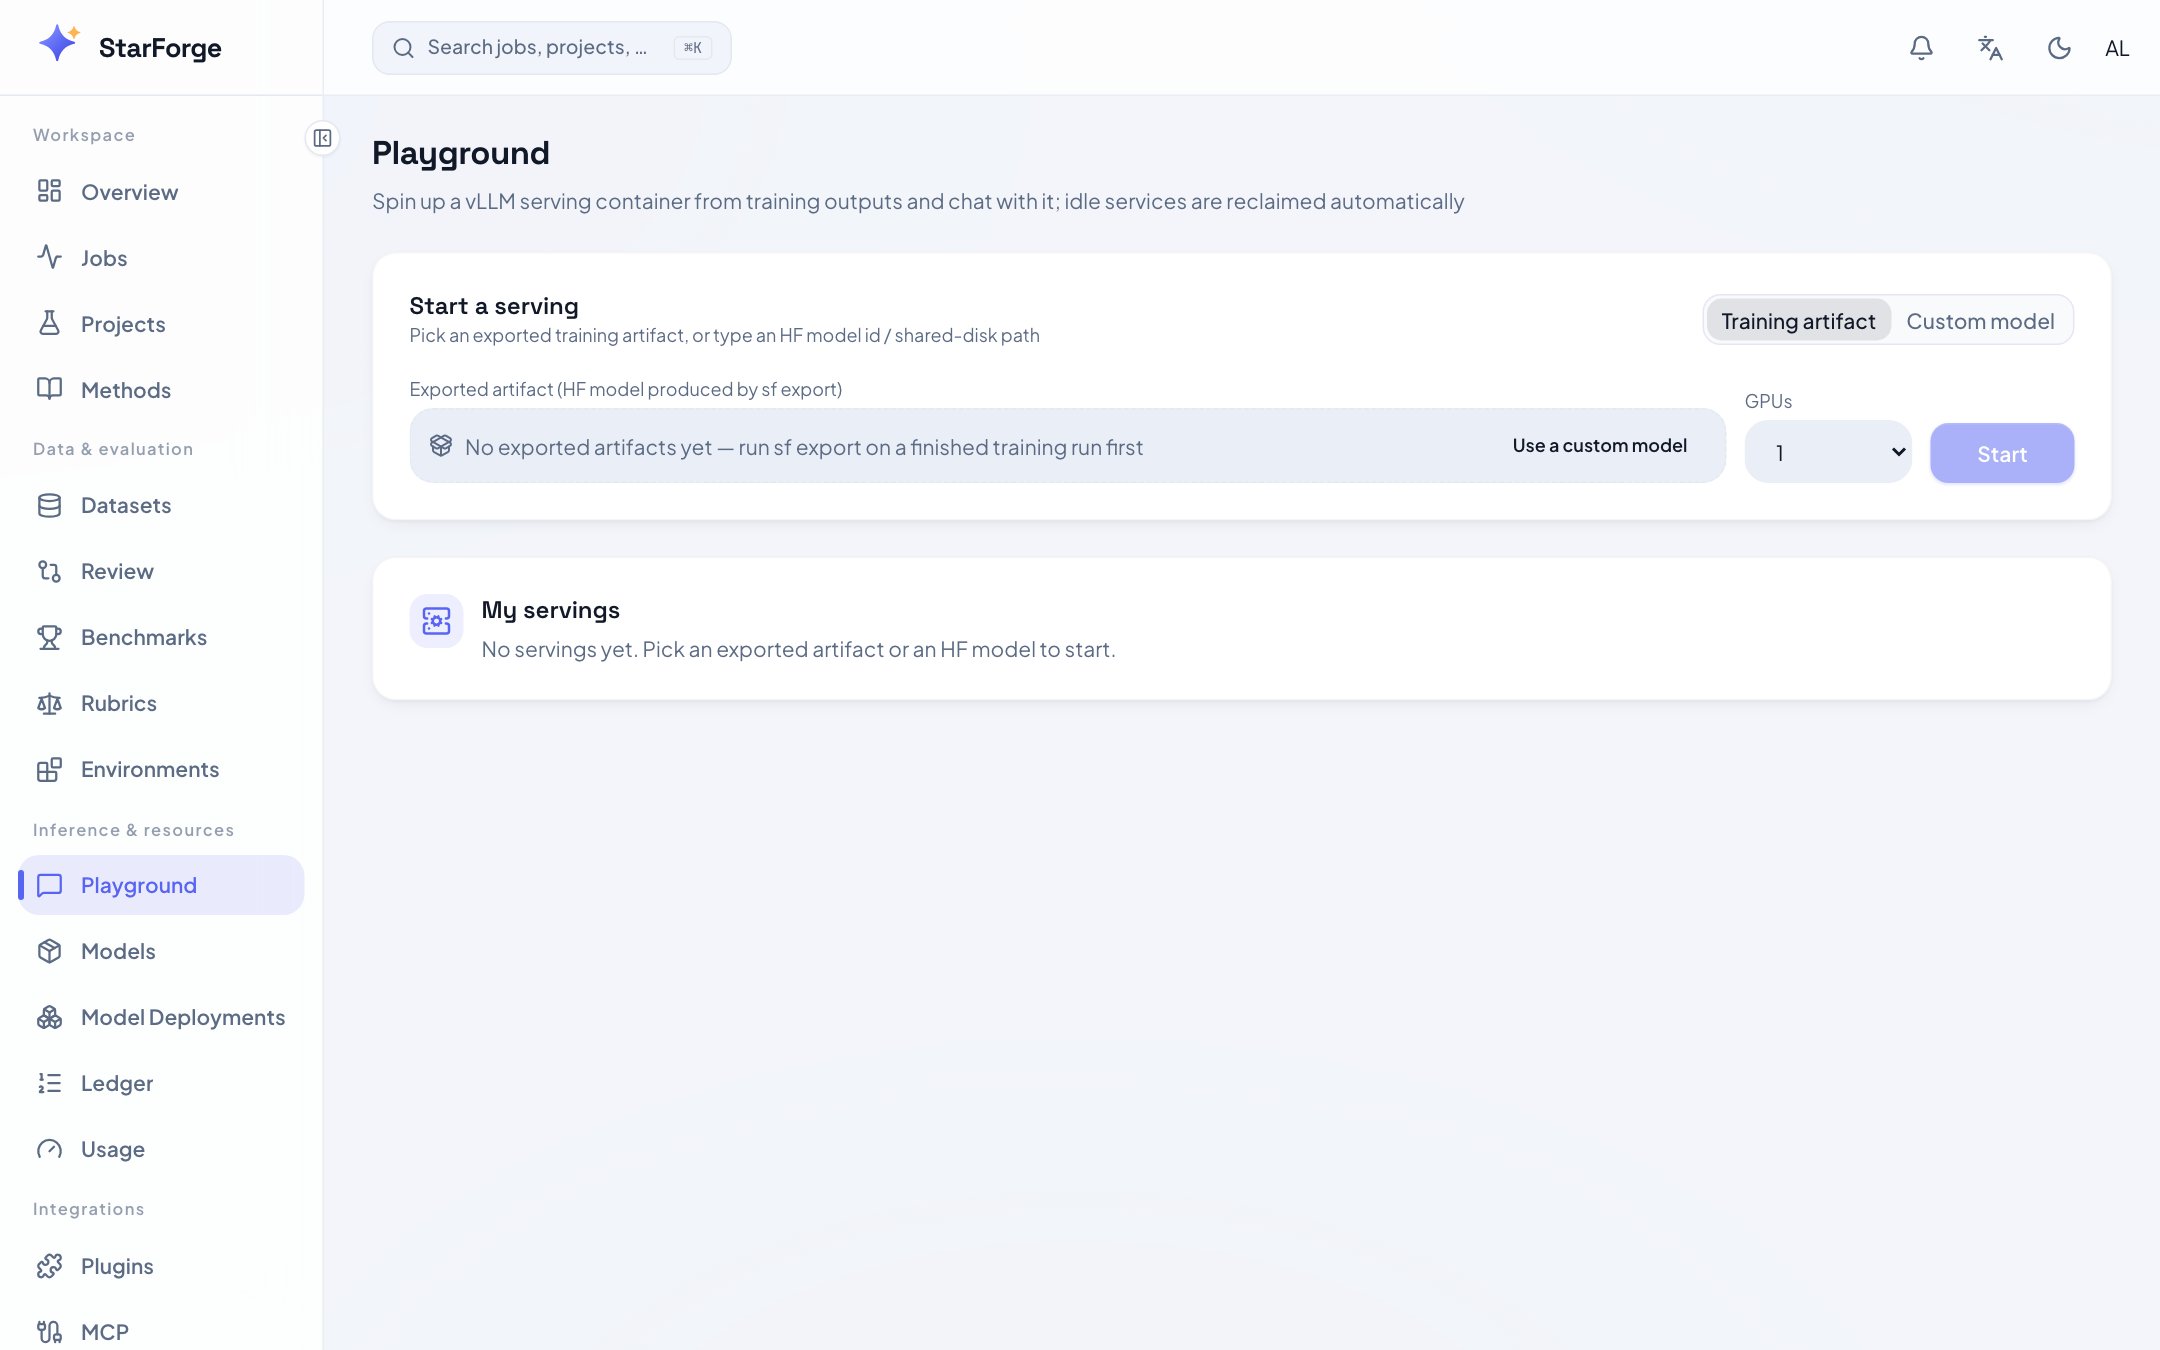
Playground:从训练导出或 HF id 拉起 vLLM 服务。
你能做什么
启动一个 session
- 选择模型:训练产物下拉(有 hf_export 的 run)或直接输入 HF id / 共享盘路径;
- 选卡数(= 张量并行度)与 TTL;
- 启动。状态卡实时显示:拉起中 → 就绪 → 剩余 TTL。
聊天
流式输出,system prompt、temperature 和 max tokens 都能在两轮之间改。 对话只活在这个页面上,别处都没有:刷新就清掉,什么都不存。想把这段交流留下来,用带 Reflow 的 Model Deployment。并排比较两个
选两个就绪的服务并排:同一输入同时发送,输出并列渲染——SFT vs GRPO、v1 vs v2 的对齐差异直接肉眼可感。管理你的 session
页面列出我的全部服务:端点地址、占卡、剩余 TTL、续期 / 停止按钮。TTL 到期自动回收(防「起了忘了关」)。页面不在的时候
Playground 是一个由管理员按角色开启的高级功能,而且支持node 和 kubernetes Fleet。Node 会话会预留宿主机端口,并回传所选节点的工作负载地址;控制平面必须能访问该地址与端口。Slurm 暂不支持。